
 硬件设备
芯系统:解密虹膜数字底座的算力引擎
"芯"系统:解密虹膜数字底座的算力引擎
在虹膜识别领域,芯片就像是超级计算机的"大脑"。今天,就让我们走进虹识技术虹膜数字底座的"双芯"引擎系统,一起解密乾芯Q80和坤芯K20这两款自主研发芯片的强大实力。
它们是什么?
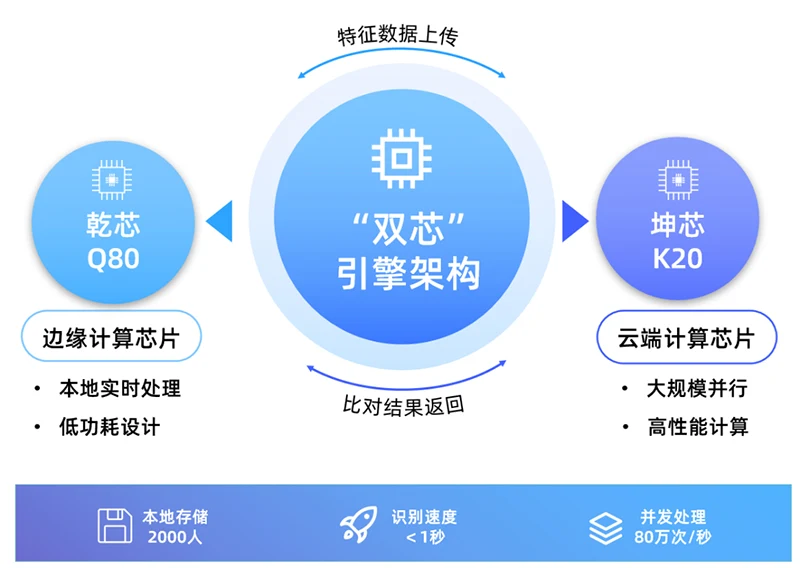
"双芯"引擎采用创新的"边缘+云端"混合架构设计:
√ 乾芯Q80:专注终端实时处理的边缘计算芯片
√ 坤芯K20:负责大规模并发的云端计算芯片
这两款芯片凝聚了虹识技术十年研发积累和创新突破,代表了当前国内虹膜识别专用芯片的最高水平。乾芯Q80专注于边缘侧的实时处理,采用40nm低功耗工艺,集成了专用ISP引擎和硬件加速单元;而坤芯K20则作为云端计算的核心,基于先进FPGA架构,可实现大规模并行计算。这种"边缘+云端"的双芯协同架构,不仅解决了虹膜识别在实际应用中的算力瓶颈,也通过合理分工大幅提升了系统整体性能和能效比。
这样的设计带来优势:
√ 本地快速响应
√ 大规模并发处理
√ 数据隐私保护
√ 成本效益优化
它们有多强?
【乾芯Q80:边缘计算的利器】
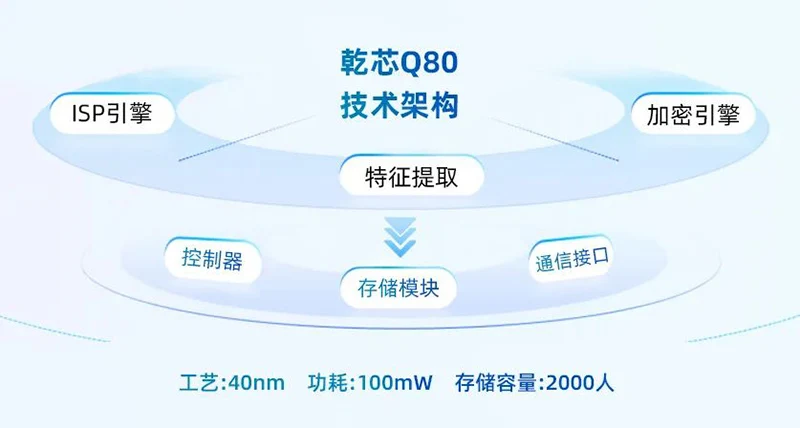
乾芯Q80是虹识技术自主研发的边缘计算ASIC芯片,专为虹膜识别场景优化设计。这款采用40nm低功耗工艺的芯片,集成了虹膜图像处理、特征提取、模板比对等核心功能模块。其内置的专用ISP引擎能够针对虹膜图像特点进行实时增强和质量评估,确保在不同光照条件下获得高质量图像;而硬件加速单元则将虹膜特征提取和编码算法直接实现在电路层面,显著提升处理速度同时降低功耗。
芯片支持2000人虹膜模板的本地存储,内置硬件加密引擎保障数据安全,功耗低至100mW,非常适合移动和物联网终端设备集成。在实际应用中,乾芯Q80能够在亚秒级完成虹膜图像采集、处理和1:1身份认证全流程,同时支持活体检测和美瞳检测功能,有效防范假体攻击。
核心技术指标:
√ 支持2000人虹膜模板存储
√ 识别速度<1秒
√ 功耗低至100mW
√ 集成ISP引擎
作为国产虹膜识别芯片的代表作,乾芯Q80已获国家科学技术成果证书,通过了湖北省电子信息产品质量监督局芯片检验认证,目前已成功应用于智能门禁、智能门锁和移动身份认证等多款终端产品,为边缘侧提供了强大而高效的算力支持。
权威认证:
√ 国家科学技术成果证书
√ 半导体产业突破技术推荐
√ 电子信息产品质量认证
【坤芯K20:云端计算的中枢】
坤芯K20是虹识技术基于先进FPGA技术开发的云端高性能虹膜识别专用芯片,专为大规模并发比对设计。采用高度并行化的计算架构,单芯片可支持每秒80万次1:N搜索比对,在HML1000服务器中部署三张比对卡可实现峰值240万次/秒的处理能力。芯片内置的高速缓存系统和智能调度引擎能够优化数据流转和计算资源分配,有效降低系统延迟,确保在大规模并发场景下仍能保持毫秒级响应。
与传统CPU/GPU方案相比,坤芯K20将虹膜比对算法的关键路径进行了硬件优化,显著提升了计算效率和能效比。芯片支持动态重构,可随着算法升级进行功能更新,保障了解决方案的长期竞争力。此外,坤芯K20还内置了完善的容错机制和自检功能,支持热插拔和负载自动均衡,为7×24小时不间断运行提供了可靠保障。
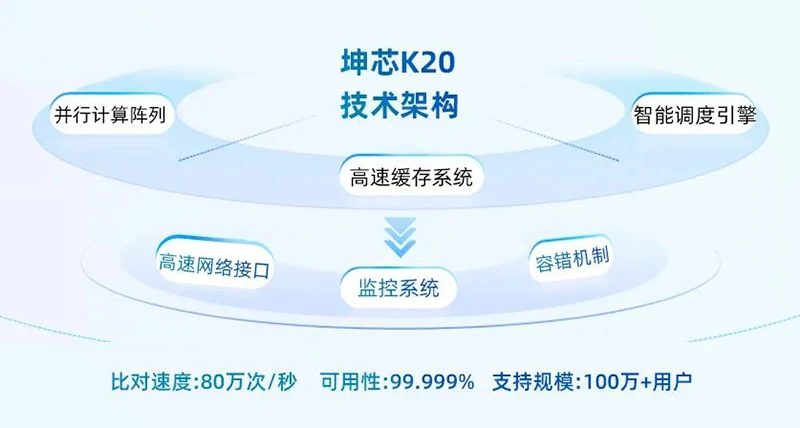
核心技术指标:
√ 每秒80万次比对
√ 支持100万级用户规模
√ 7×24小时稳定运行
√ 支持多卡级联扩展
作为云端计算中枢,坤芯K20已在公安刑侦、智慧金融、智慧监管等大型虹膜识别系统中得到广泛应用,支持众多用户规模的身份搜索服务。其良好性能为虹膜识别在大规模应用场景中的落地提供了强大的算力支撑,也为虹识技术在高性能计算领域的技术积累奠定了坚实基础。
关键创新点在哪?
【乾芯Q80创新特性】
乾芯Q80在芯片架构和功能设计上融入了多项创新技术,实现了虹膜识别专用处理能力的重大突破。在ISP处理方面,芯片集成了自适应虹膜增强引擎,采用专利的"一种用于虹膜识别的自动曝光控制方法"技术,能够智能分析入射光线特性,在0.01-100,000lux宽泛光照范围内实现理想虹膜成像,有效解决了现实场景中光照不稳定问题。同时,内置的噪声抑制和对比度增强单元可在弱光条件下提取更多虹膜纹理细节,显著提升识别精度。
在算法加速方面,Q80采用了异构计算架构,将PhaseIris™3.0算法中计算密集型操作如Gabor滤波、相位量化等环节通过专用硬件电路实现,相比软件实现提速5-8倍,同时将功耗降低70%。芯片还采用创新的流水线并行处理机制,实现了图像采集、特征提取、模板比对的并行化处理,将端到端响应时间控制在500ms以内。
在安全防护层面,Q80集成了基于PUF(物理不可克隆功能)技术的硬件安全模块,实现芯片级别的数据加密保护。每颗芯片在制造过程中产生独特的硬件指纹,杜绝了克隆和篡改可能性。此外,芯片还支持安全启动和固件完整性验证,防止恶意代码注入,并采用多级防护机制保障存储在芯片内的虹膜模板数据安全,即使芯片落入他人手中也无法提取敏感信息。
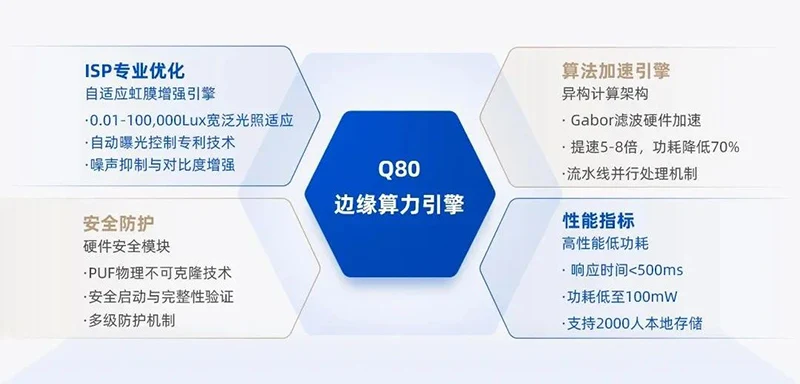
这些创新特性使乾芯Q80成为目前市场上集成度高、性能优、安全性强的虹膜识别专用边缘计算芯片,为终端设备提供了强大的本地处理能力,同时确保了用户隐私和系统安全。
ISP专业优化:
√ 虹膜图像增强
√ 自动曝光控制
√ 实时质量评估
算法加速引擎:
√ 特征提取硬加速
√ 模板比对硬加速
√ 活体检测支持
安全防护:
√ 硬件加密引擎
√ 安全启动机制
√ 数据防篡改
【坤芯K20创新特性】
坤芯K20作为云端虹膜识别专用计算芯片,融合了多项前沿技术创新,实现了大规模并行计算的良好性能。在并行计算架构方面,K20采用了创新的网格化计算阵列设计,将虹膜特征比对任务分解为数千个独立计算单元同时处理。每个计算单元都针对相似算法进行了优化设计,配合全局资源调度器,可实现计算资源的动态分配,根据任务复杂度自适应调整,将计算效率提升至传统CPU架构的15-20倍。
在数据处理技术上,K20芯片设计了三级缓存架构和智能预取机制,根据历史访问模式预先加载虹膜模板数据,有效降低内存访问延迟,大幅提升数据吞吐率。同时,采用创新的数据压缩算法,在保持比对精度不变的前提下,将模板存储空间压缩40%,支持更多模板并发加载。芯片内置的流水线比对引擎能够进行无缝任务切换,实现近乎满载的资源利用率,最大化系统整体性能。
在可靠性保障方面,K20实现了全芯片级的容错机制,包括计算冗余、校验码保护和自诊断技术,能够实时监测各计算单元状态,在检测到异常时自动隔离故障单元并重新分配任务,确保7×24小时连续工作的稳定性。此外,芯片支持热插拔技术,允许在系统运行过程中动态扩展计算资源,无需停机即可完成系统扩容。
作为可重构计算平台,K20还提供了灵活的算法升级通道,支持在不更换硬件的情况下,通过固件更新实现算法优化和功能扩展,有效延长了系统生命周期,降低了用户总体拥有成本。这些创新特性使坤芯K20成为云端大规模虹膜识别的理想计算平台,为众多用户规模应用提供强大的算力支持。
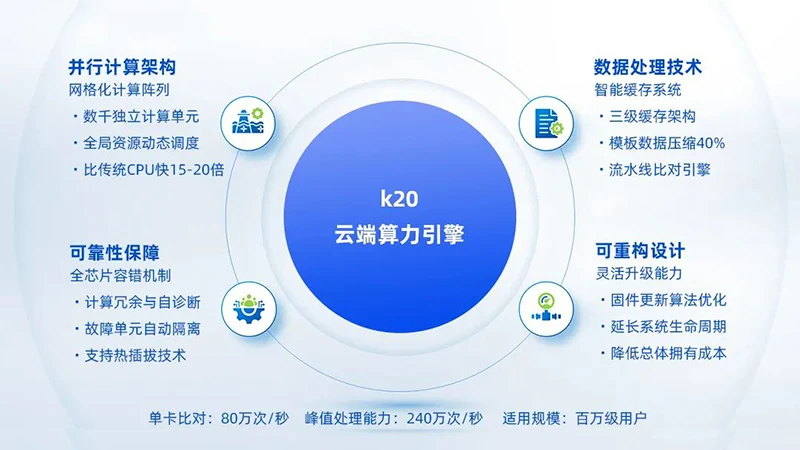
并行计算:
√ 多核心架构
√ 智能任务调度
√ 负载自动均衡
数据处理:
√ 高速缓存系统
√ 智能数据调度
√ 实时数据分析
可靠性保障:
√ 故障自动恢复
√ 数据实时备份
√ 系统状态监控
性能对比
与传统实现方式相比较,在计算性能、响应速度、并发能力、可靠性、功耗效率和成本效益六个关键维度上,双芯方案(灰色区域)均显著超越传统方案(蓝色区域)。尤其在响应速度和并发能力方面,双芯方案的优势更为明显,这主要得益于边缘计算与云端计算的协同设计。通过乾芯Q80负责本地快速处理,坤芯K20提供大规模并行计算能力,双芯方案在保持高性能的同时,还实现了更高的可靠性和更优的功耗比,为大规模虹膜识别应用提供了理想的算力支撑平台。这种全方位的性能提升,使虹识技术在竞争激烈的生物识别市场中建立了显著的技术优势。
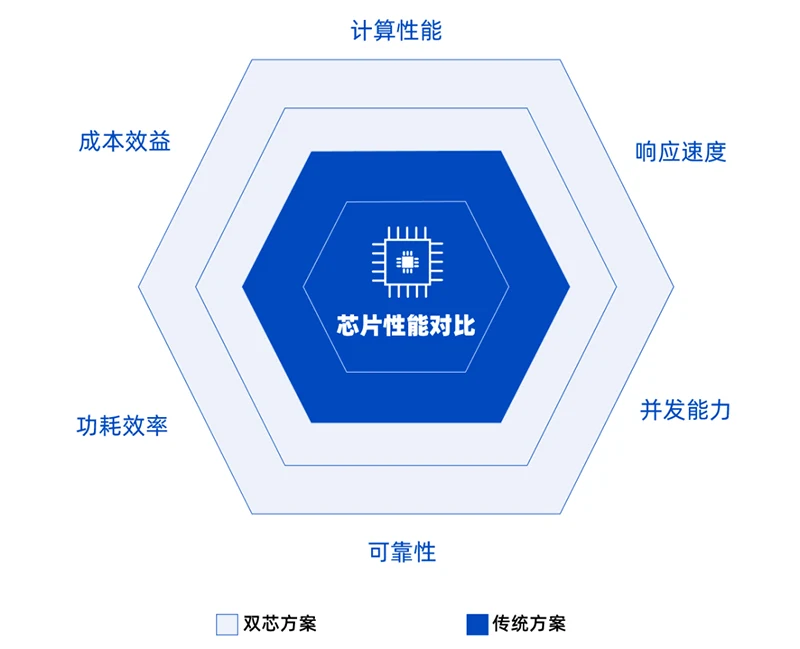
关键指标:
√ 识别速度提升200%
√ 功耗降低50%
√ 成本降低30%
√ 可靠性提升80%
芯片进化
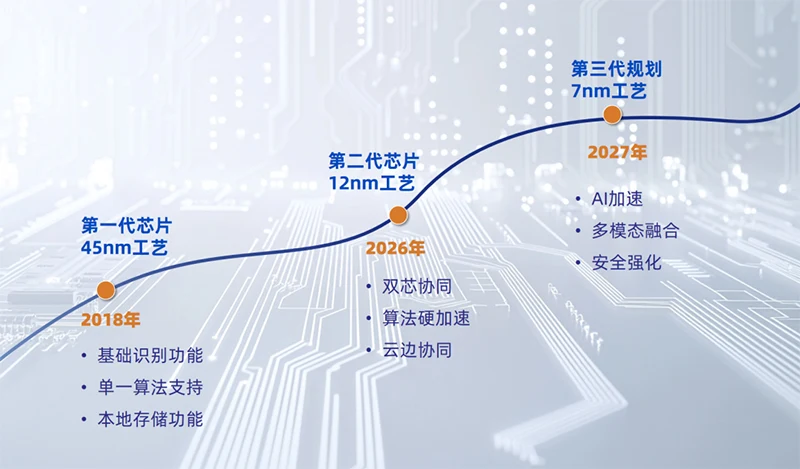
这张芯片技术演进路线图展示了虹识技术芯片产品的三代发展历程。第 一代芯片采用45nm工艺,于2018年推出,主要实现了基础识别功能、单一算法支持和本地存储功能。第二代芯片计划于2026年推出,将采用更先进的12nm工艺,实现双芯协同、算法硬加速和云边协同等技术突破。第三代芯片规划于2027年推出,工艺将进一步提升至7nm,并将引入AI加速、多模态融合和安全强化等前沿技术。这条路线图清晰展示了虹识技术在芯片研发上的长期规划和技术演进方向,体现了从基础功能到高级智能化的发展趋势。
三代演进:
√ 算法效率提升
√ 功耗持续优化
√ 成本不断降低
√ 集成度提升
√ 成本降低
结语
虹识技术将继续在芯片技术领域深耕,通过自主创新,为用户提供更强大、更高效的虹膜识别解决方案。从45nm到7nm工艺的演进,从单一功能到AI加速的升级,虹识技术的芯片研发路线图不仅体现了技术实力,更展现了长远战略眼光。随着第二代12nm工艺芯片的即将问世和第三代7nm芯片的规划推进,我们有理由相信,虹识技术的"双芯"引擎将在性能、功耗和安全性等方面取得质的飞跃,为大规模虹膜识别应用提供更坚实的算力支撑。
在数字化转型日益深入的今天,生物识别技术正成为连接物理世界与数字世界的关键纽带。虹识技术通过持续的芯片创新,不仅推动了虹膜识别技术的普及应用,也为整个生物识别产业树立了技术标杆。让我们共同期待"双芯"引擎为数字化转型带来的更多可能,共同开创更加安全、便捷、智能的数字生活新篇章!